开集识别和对抗样本拒识
深度学习模型的训练中,往往因为收集的数据有限(闭集),在应用推理预测阶段面对真实数据(开集)时会存在表现不好、误识别的问题。比如在CV中的分类模型来说,由于卷积的特性往往会将标签体系外的图片高概率预测成为标签体系内的;nlp中也会存在将领域外的文本语句预测成为领域内的意图;语音唤醒模型中也会经常误唤醒。记录一下一些解决这类问题的方式:
**开集识别:**Open Set Recognition, 其主要目标就是判别领域内的样本,同时识别出领域外的样本。对比于普通分类、小样本学习、零样本学习在训练数据、和目标均有区别。该OSR 领域内的进展可以参考综述" [论文] Recent Advances in Open Set Recognition A Survey" . 其中OpenMax 是一个比较常见的方法,其主要思想是判断待预测样本的输出特征与训练样本中各个类别的平均特征做计算,根据该距离,利用极值分布的方式调整对于类别的概率,其中调整微调掉的概率为未知类别的概率。OpenMax 不改变模型的训练过程,仅更改特征向量到类别的预测方式,实际上是softmax的一个替换(扩展到N+1类)。
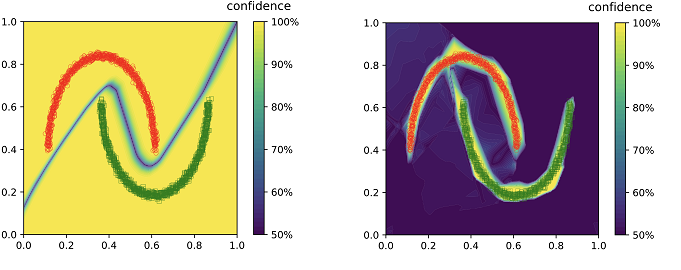
**对抗样本:**对抗攻击和对抗防御是深度学习中一个研究方向。其中对抗攻击中主要使用的是模型的梯度,通过对正常样本添加微笑的扰动,一般为模型的梯度方向(预测结果改变最大的方向),使得在样本基本没有变化的情况下,模型给出了错误的结果。其中对抗防御一般的做法是将这些对抗样本添加到模型中训练,从而避免预测错误。Why ReLU networks yield high-confidence predictions far away from the training data and how to mitigate the problem 。 下面图示的二分类样本在整个样本空间中的预测概率分布图,添加对抗样本训练后预测概率黄色部分(接近1)的地方显著减少,预测区域更趋向于真实样本分布。
**Out-of-domain问题:**在做nlp的时候也面临着OOD的问题,调研中主要有两个方向去进行OOD 问题解决。1 模型增加OOD 的识别能力;2模型提高在IND的能力。
增加OOD的识别能力的一个代表方法为DRM, 主要有两个点,在最后的线性分类器时添加domain的分类器fd,计算loss误差时用fd来修正;除了新增分类器外,还会用上述类似OpenMax的方式去计算预测特征与模型类别中心特征之间的距离来微调,只不过由于NLP模型大多采用transformer结构,也会参考中间层的特征的距离来微调。
好的OOD方法离不开一个好的IND模型,因此也有部分工作利用对比学习和对抗样本的方式,提升IND 模型在类别之间的界限,使得同类标注的数据在特征空间中尽量紧凑,预测边界清晰。
总结:上述的方式都是无监督的方式,若是业务数据相对不是开集,可以采用有监督的方法,收集对应的闭集外数据,讲模型在训练阶段由N分类扩展到N+1类。